现在,AI 生成音乐又进化了一步。
引子:想“做”一首歌,你其实卡在这几步
先对号入座一下:
- 脑子里有段旋律、几句词,想做成一首完整的歌,但不会写谱、不会编曲、更找不到歌手?
- 试过在线 AI 音乐工具,结果要订阅、有次数限制,歌还存在别人服务器上、商用心里没底?
- 给短视频找 BGM,翻遍版权音乐库都不贴合画面,定制的又贵又慢?
- 听说 AI 音乐很强,但总觉得“那是大厂玩具”,自己电脑跑不了?
如果你中了两条以上,那 MiniMax Music 3 值得你花十分钟。它不是一个“能哼两段旋律的玩具”,而是把一句歌词 / 一段风格描述 → 人声演唱 → 旋律编曲 → 伴奏,在你自己电脑上一次性合成一首最长约 5 分钟的完整歌曲的开源模型。
下面先把优点讲透,再上详细部署教程。
一、这套方案是什么
MiniMax Music 3 是 MiniMax 最新开源的音乐生成模型。它的核心能力是:你只需要给一句简单的歌词或一段文字描述,它就能直接生成一首完整的 5 分钟歌曲——从人声演唱、旋律到编曲伴奏,全部一次性完成。
最关键的一点:这次模型开放了权重,不是只给在线体验。普通用户可以把模型下载下来,在自己的电脑上本地部署、本地运行,创作内容不出本机。
二、为什么是 MiniMax Music 3:它到底好在哪
2.1 先说痛点:做一首歌,传统方式有多麻烦
| 你想要什么 | 传统方式的尴尬 | MiniMax Music 3 怎么解 |
|---|---|---|
| 做一首原创歌 | 写词、写曲、编曲、找歌手、混音,门槛高、成本高 | 一句歌词 + 风格描述,本地直接出整首 |
| 用在线 AI 音乐 | 要订阅、限次数,歌出云端、商用存疑 | 权重开源本地跑,免费、数据不出本机 |
| 短视频配乐 | 版权音乐难贴合,定制贵又慢 | 描述风格直接生成贴合的歌曲 / BGM |
它的定位,正好补齐这一整片空白:把“写歌”这件原本需要团队和设备的专业活,变成个人电脑上“输入文字、输出成曲”的一件事。
2.2 6 大优点详解
① 开放权重,真正可本地部署——最核心的卖点
模型权重公开下载,不用被在线平台订阅和次数卡脖子,创作内容在自己机器上跑,隐私和版权都更可控。
② 一句歌词,直接出 5 分钟完整歌
不是生成 15 秒片段让你拼接,而是人声、旋律、编曲、伴奏一次性合成一首最长约 5 分钟的完整作品。这是它和很多“片段式”音乐模型最大的区别。
③ 曲风精细可控
靠一段 Style Prompt(风格描述)就能定下 BPM、乐器、人声性别与音色、情绪走向。想做欢快舞曲还是催泪抒情,你说了算。
④ 零门槛,不用乐理
不需要会写谱、会编曲、会混音。ComfyUI 里拖入工作流,填歌词和风格,点一下就出歌。
⑤ 速度快,等得起
实测 24G 显存下:生成 60 秒的歌约 20 秒,生成 4~5 分钟的歌约 1~2 分钟。比起传统制作周期,几乎是“即写即听”。
⑥ 人声歌曲 / 纯音乐都行
带人声的歌曲、或者纯 BGM,都能生成。短视频配乐、个人 Demo、灵感记录通吃。
2.3 它还能做到什么(实测与能力清单)
- 输入:歌词 + 音乐风格描述(纯文字)。
- 输出:最长约 5 分钟完整歌曲,含人声演唱。
- 模型组成:Diffusion(DiT)主体 ×2 + 文本编码器 + VAE,共 4 个文件。
- 显存方案:提供 fp16 满血版与 int8 低显存版,按需选。
- 实测速度(8G 显存):60 秒歌曲 ≈ 2分20 秒生成;4~5 分钟歌曲 ≈ 10~15分钟生成。
- 支持类型:带人声歌曲、纯音乐均可。
2.4 谁最适合用(对号入座)
✅ 想做原创 / Demo 的音乐爱好者
✅ 短视频创作者,急需贴合画面的定制配乐
✅ 在意隐私、想把 AI 音乐跑在本地的人
✅ 手上有 8G 以上显卡、愿意折腾 ComfyUI 的人
❌ 完全没有独立显卡、显存极小的人——即便 int8 版也吃资源。
❌ 追求录音室级母带品质、需要精细后期的人——它是“成曲生成”,不是专业 DAW。
❌ 完全不想碰 ComfyUI、怕配置的人——部署还是要装环境、下模型。
三、部署前准备
- 一台装有 NVIDIA 独立显卡的电脑(显存越大越快;低显存可选 int8 版模型)。
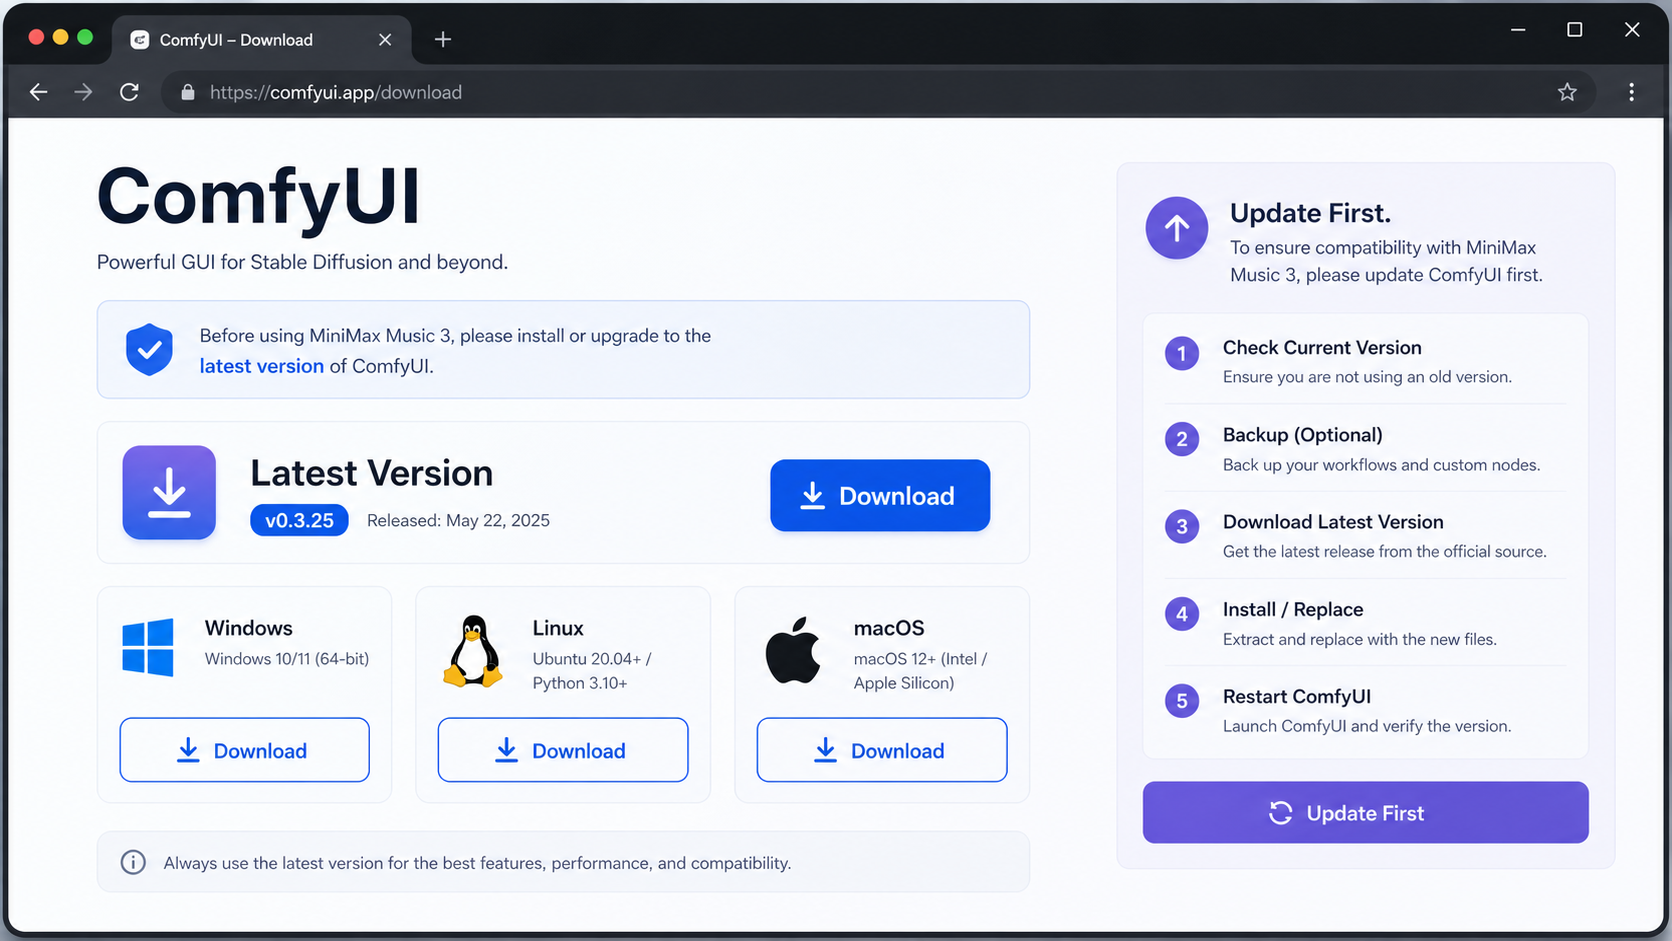
- 已安装或准备安装 ComfyUI,且必须是适配 MiniMax Music 3 的最新版。
- 足够的磁盘空间:4 个模型文件体积不小(fp16 满血版更大)。
- 网络环境能访问 HuggingFace 或国内网盘以下载模型和工流。
⚠️ 关键提醒:如果你之前装过 ComfyUI,务必升级到最新版,否则无法识别 MiniMax Music 3 模型。
四、第一步:下载并升级 ComfyUI
前往 ComfyUI 官网下载最新客户端:
- 官方下载:https://comfy.org/
已安装旧版的用户,先升级再继续。
五、第二步:下载 4 个模型
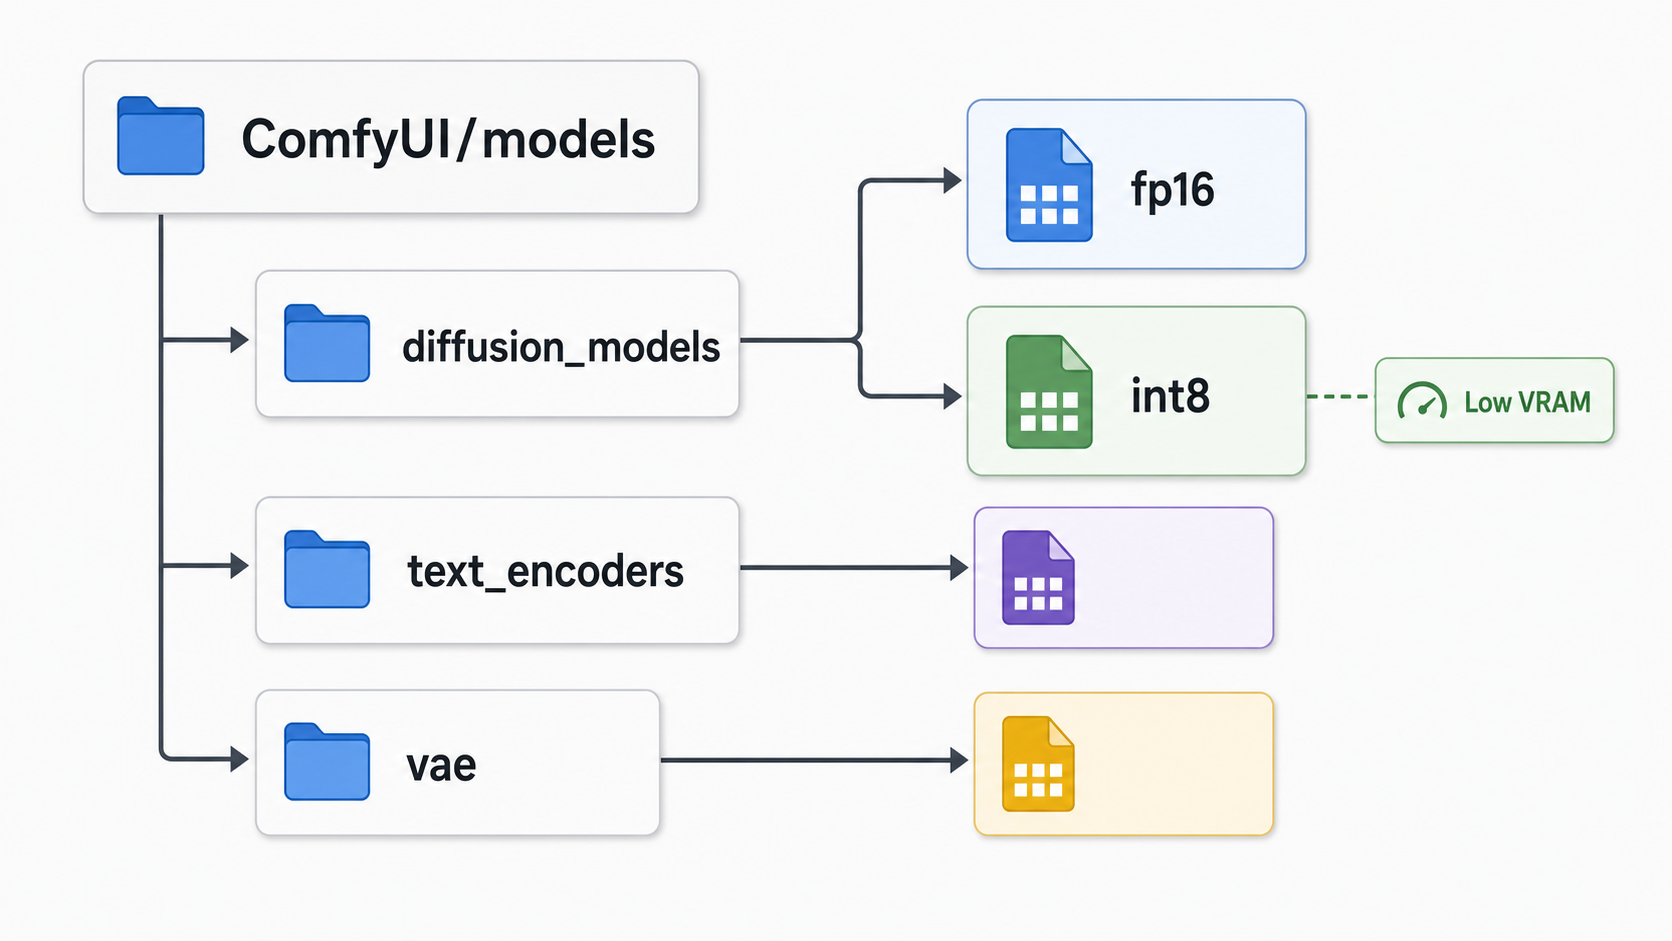
MiniMax Music 3 共需 4 个模型文件,按下面的目录结构放到 ComfyUI 的 models/ 下:
<code class="language-text">ComfyUI/
├── models/
│   ├── diffusion_models/
│   │   ├── minimax_music3_dit_int8_convrot.safetensors   # 低显存用户选择
│   │   └── minimax_music3_dit_fp16.safetensors           # 全精度 满血版
│   ├── text_encoders/
│   │   └── minimax_music3_text_encoder_pruned_int8_convrot.safetensors
│   └── vae/
│       └── minimax_music3_dav.safetensors
</code>
1、diffusion_models(二选一)
- minimax_music3_dit_fp16.safetensors(全精度 满血版)
HuggingFace:https://huggingface.co/Comfy-Org/MiniMax-Music-3/resolve/main/diffusion_models/minimax_music3_dit_fp16.safetensors
网盘:https://pan.quark.cn/s/d4b4f572b306 - minimax_music3_dit_int8_convrot.safetensors(低显存用户选择)
HuggingFace:https://huggingface.co/Comfy-Org/MiniMax-Music-3/resolve/main/diffusion_models/minimax_music3_dit_int8_convrot.safetensors
网盘:https://pan.quark.cn/s/d4b4f572b306
2、text_encoders
- minimax_music3_text_encoder_pruned_int8_convrot.safetensors
HuggingFace:https://huggingface.co/Comfy-Org/MiniMax-Music-3/resolve/main/text_encoders/minimax_music3_text_encoder_pruned_int8_convrot.safetensors
网盘:https://pan.quark.cn/s/28ac5d7b75de
3、vae 编码器
- minimax_music3_dav.safetensors
HuggingFace:https://huggingface.co/Comfy-Org/MiniMax-Music-3/resolve/main/vae/minimax_music3_dav.safetensors
网盘:https://pan.quark.cn/s/0e238994b17f
六、第三步:下载工作流
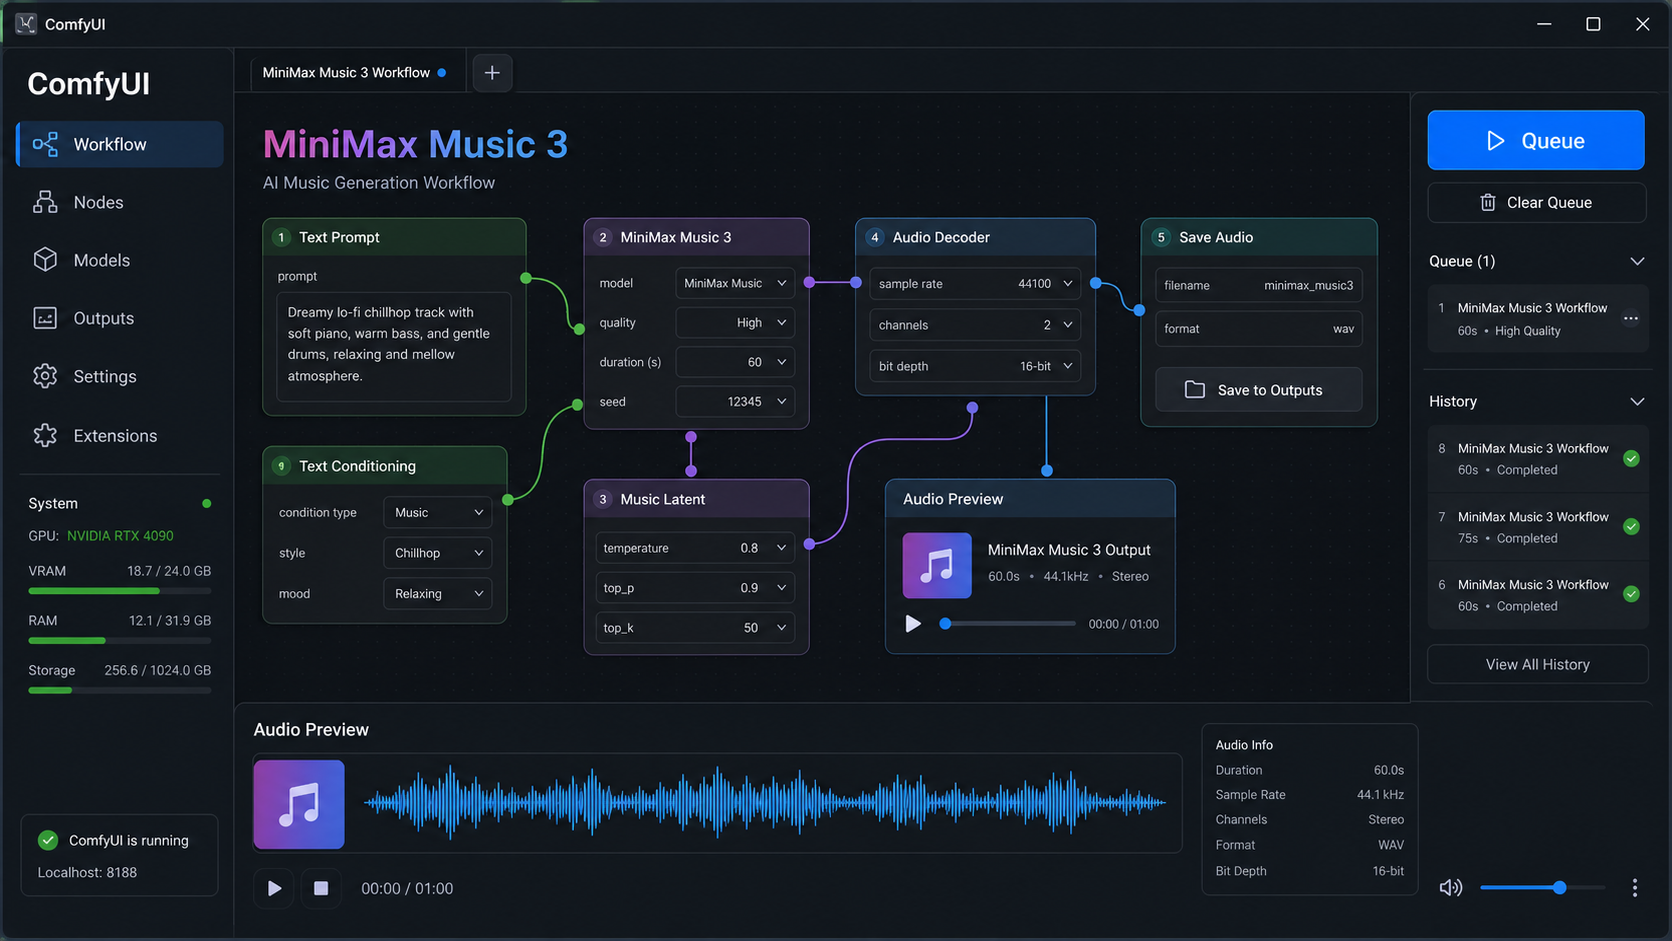
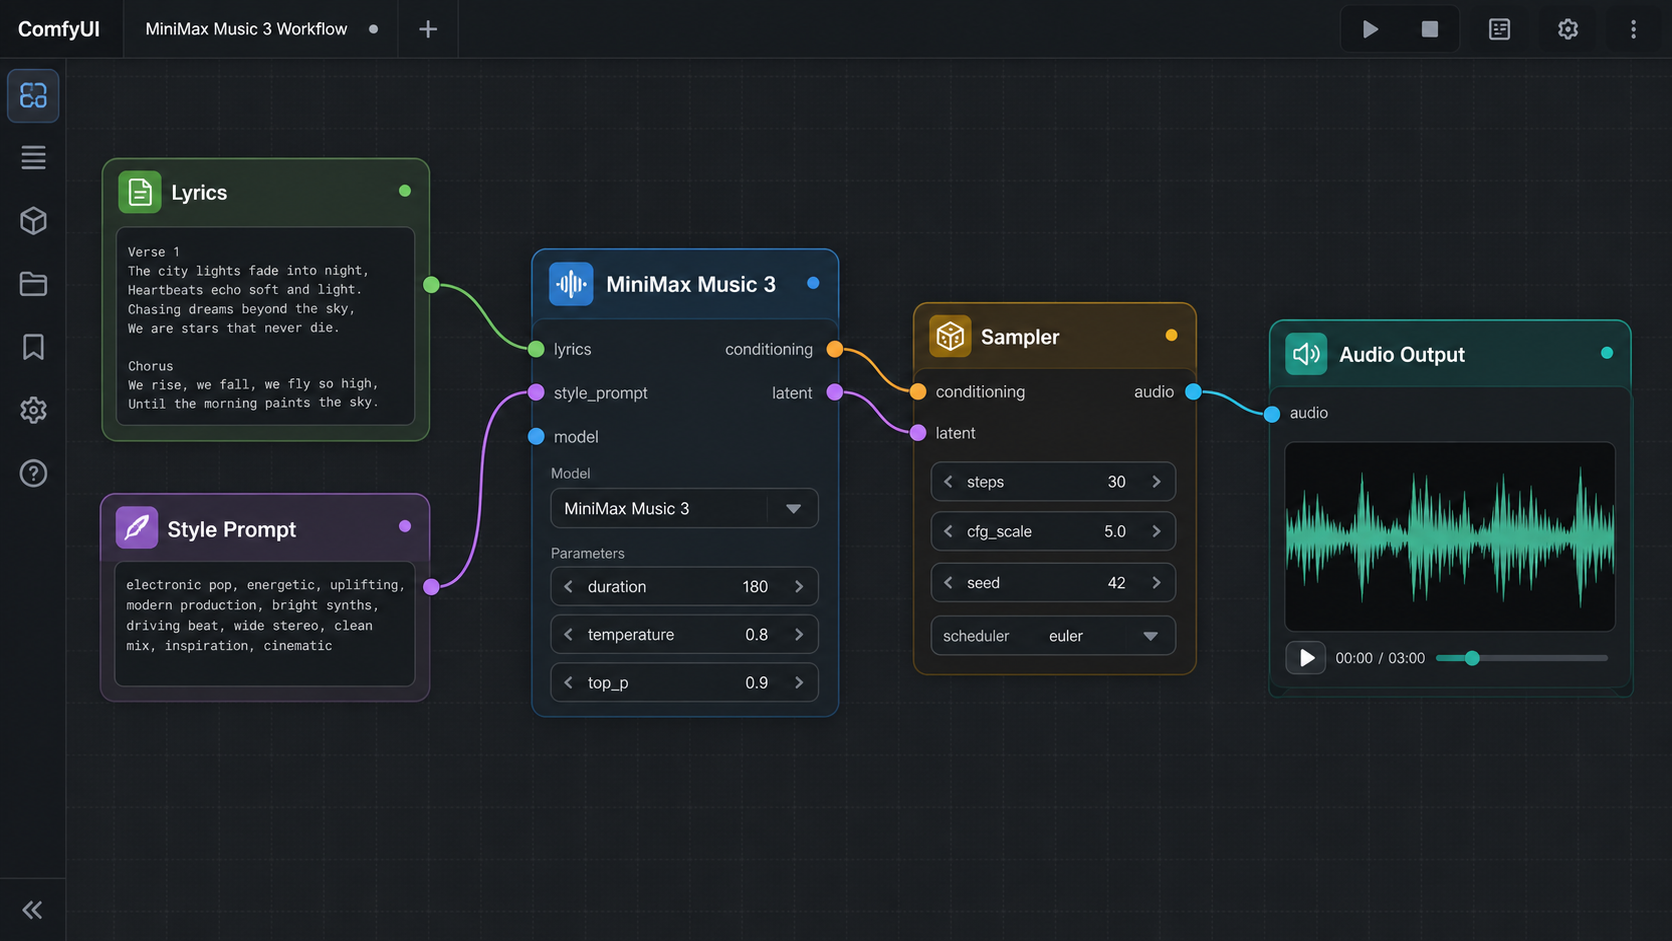
将工作流文件直接拖入 ComfyUI 的空白工作区即可使用。
七、运行与实测
把下载的工作流拖入 ComfyUI 后,在对应节点输入歌词和歌曲曲风描述,就可以本地生成任意你需要的音乐——带人声的歌曲、或纯音乐都没问题。
八、提示词怎么写
MiniMax Music 3 的效果很大程度取决于 Style Prompt(风格描述)和歌词质量。告诉一个窍门,把这事可以交给大模型处理,哈哈
九、注意事项与坑
- ComfyUI 必须最新版:旧版无法识别 MiniMax Music 3 模型,部署前先升级。
- 模型放对目录:4 个文件严格按
diffusion_models / text_encoders / vae子目录放置,否则读不到。 - 显存取舍:大显存用 fp16 满血版保质量;显存紧张用 int8 版。
- 下载源选择:HuggingFace 或文内夸克 / cloudeop 网盘均可,按网络情况选。
- 商用注意:生成的音乐用于发布前,请自行确认模型许可与平台规则。
十、一句话结论
MiniMax Music 3 的价值在于:它把“写一首歌”从需要团队和设备的专业活,变成了个人电脑上“输入文字、输出成曲”的一件事——而且权重开源、可本地跑、5 分钟完整歌曲、速度与质量都够用。部署时最重要的不是“装好”,而是先升级 ComfyUI、按目录放对 4 个模型、再用工作流填好风格与歌词。
你最想用 AI 生成哪种歌?是想给短视频配一段专属 BGM,还是想把自己写词变成能唱出来的完整 demo?欢迎在评论区聊聊你的场景。


