宝子们,今天挖到一个"小而猛"的开源语音项目——MOSS-TTS-Nano。
它由 复旦大学 NLP 实验室 × 模思智能 × 上海创智学院 联合开源,参数只有 0.1B(1 亿),却能在纯 CPU、4 核上实时流式出声,音质还是原生 48kHz 双声道立体声,还支持零样本声音克隆和 20 种语言。
简单说:你想给视频配旁白、做数字人配音、出海多语种朗读,但被"显卡劝退"的,这个项目就是为你准备的。
引子:你是不是也被这 4 个问题劝退过?
- 想给视频配旁白 / 做 AI 配音,结果开源 TTS 动辄要显卡,没卡的根本跑不起来?
- 好不容易找个"小模型",合成出来却是"电话音"——24kHz 单声道,干瘪、没空间感?
- 想克隆自己的声音做数字人,要么要几百 G 显存,要么得微调训练大半天?
- 做出海内容需要多语种配音,现成方案要么贵、要么语种少得可怜?
如果你中了任意一条,那这个 1 亿参数的"小钢炮"值得你花 5 分钟看看。下面先讲清它"强在哪",再手把手带你从零跑通。
一、这套方案是什么
MOSS-TTS-Nano 是 MOSI.AI(模思智能)与 OpenMOSS 团队开源的多语言微型语音生成模型,定位非常明确:
在 TTS 部署里最重要的三件事上做减法——小体积、低延迟、够用的实时音质,外加极简的本地部署。
- 项目地址:https://github.com/OpenMOSS/MOSS-TTS-Nano
- 出品方:复旦大学自然语言处理实验室 × 模思智能 × 上海创智学院
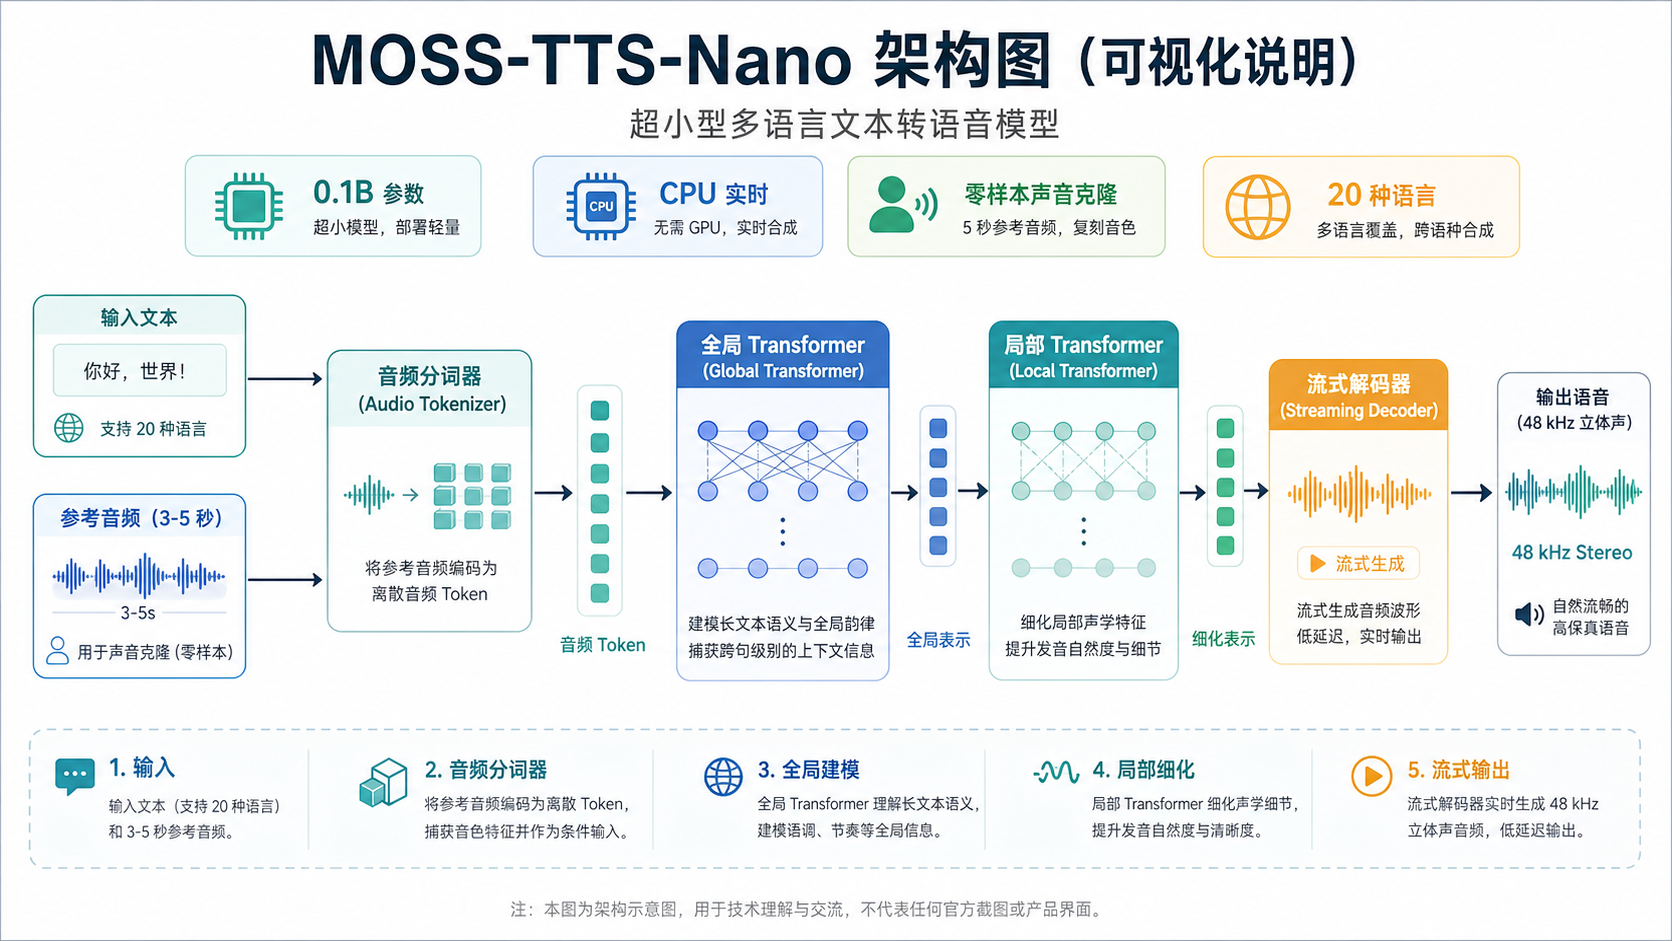
- 参数量:0.1B(主模型)+ 约 20M 的 Audio Tokenizer ≈ 120M,模型权重仅几百 MB
- 架构:纯自回归 Audio Tokenizer + LLM(Global & Local 双 Transformer,"大脑统筹 + 嘴巴快跑")
- 输出规格:原生 48 kHz、双声道(立体声)——这是它最越级的一点
- 协议:Apache 2.0(以仓库根
LICENSE文件为准),可商用、可改 - 在线 Demo:https://openmoss.github.io/MOSS-TTS-Nano-Demo/
二、为什么是 MOSS-TTS-Nano:它到底好在哪(重点)
2.1 先看痛点:主流开源 TTS 的"不可能三角"
| 你的处境 | 主流方案的尴尬 |
|---|---|
| 没显卡 / 只有笔记本 | 动辄几 B 的 TTS 根本跑不动,上云又烧钱 |
| 用小模型将就 | 大多只给 16k/24k 单声道,"电话音"、机器味重 |
| 想克隆声音 | 要么要 GPU 微调,要么参考音频要很长 |
| 做出海内容 | 多数轻量模型只支持中英,语种不够 |
MOSS-TTS-Nano 的解法是:参数做减法,音质和语种做升舱——用极致架构把"实时 + 立体声 + 克隆 + 多语"塞进了 1 亿参数里。
2.2 八大优点,逐条说清楚
① 极致轻量:1 亿参数,权重几百 MB
对比 ChatTTS 约 0.2B、Fish-Speech / CosyVoice 动辄数百 M~数 B,Nano 体积小到能塞进浏览器插件和手机。
② 真·CPU 可跑,不要显卡
流式生成 4 核 CPU 即可实时推理;ONNX CPU 版在 MacBook Air M4 上单核就能流畅跑。迷你主机、旧笔记本、甚至边缘设备都能本地合成。
③ 音质越级:原生 48kHz 双声道立体声
主流零样本 TTS 大多卡在 24kHz 单声道,听起来像"电话音"。Nano 原生 48kHz 立体声,保留呼吸声、环境混响和空间方位感,彻底摆脱干瘪感。
④ 零样本声音克隆:3–5 秒参考音频即可
录一小段参考音频,它就能精准复刻你的音色、发音习惯,无需训练、无需微调,直接出结果。
⑤ 20 种语言,出海友好
中文、英文、日、韩、法、德、西、俄、意、葡、阿、波斯……等 20 种语言。用一种声音作参考,就能让它"说"地道外语,适配全球化 AI 助手。
⑥ 极低延迟:100ms 内出声
低首 token 延迟 + 流式解码,天然适配语音助手、虚拟数字人的实时连续对话场景。
⑦ 部署极简,ONNX 版更轻更快
提供 infer.py、app.py、打包 CLI、Web Demo,一键启动。ONNX CPU 版推理期不依赖 PyTorch,效率较原版接近翻倍,还能走 CUDA。
⑧ 开源可商用 + 生态完整
Apache 2.0 协议;家族还有浏览器插件 MOSS-TTS-Nano-Reader、Android 示例、微调代码,官方还给了论文和 API 文档。
2.3 横向对比:它和主流开源 TTS 差在哪
| 维度 | MOSS-TTS-Nano | ChatTTS | Fish-Speech | CosyVoice | Bert-VITS2 |
|---|---|---|---|---|---|
| 参数量 | 0.1B | ~0.2B | 数百 M~1B+ | 0.5B~1B+ | 数十 M~百 M |
| 音质 | 48kHz 立体声 | 24kHz 单声道 | 高 | 高(含方言) | 中 |
| 声音克隆 | 零样本 3–5s | 不支持(随机音色) | 需参考/微调 | 支持 | 需训练 |
| GPU 需求 | 不需要(CPU可) | 建议 GPU | 必须 GPU | 必须 GPU | 建议 GPU |
| 多语种 | 20 种 | 中英 | 多 | 中英多方言 | 主要中日 |
| 部署难度 | 简单(ONNX 免 PyTorch) | 中 | 较难 | 难 | 中 |
说明:对比依据各项目公开定位与社区评测整理,非逐版本实测;具体能力以官方最新版文档为准。一句话总结——MOSS-TTS-Nano 不是"最好听"的 TTS,但很可能是最容易部署、最适合本地/边缘跑的开源语音克隆方案。
2.4 适合谁 / 不适合谁
✅ 适合你,如果:
- 没显卡、只有笔记本/迷你主机,想本地跑 TTS;
- 做视频旁白、AI 配音、播客,需要"能听"的高性价比方案;
- 做数字人 / 对话机器人,要求低延迟实时出声;
- 做出海内容,需要多语种配音;
- 隐私控,希望语音本地合成不出云。
❌ 可能不适合,如果:
- 追求录音棚级"极致听感"(它够用但不是该赛道的天花板);
- 完全不愿装 Python / Conda 环境;
- 需要超精细的"长样本定制音色训练"。
三、部署前准备
- 系统:Windows / Linux / macOS 均可(本文以 Windows 为例,命令通用)
- Python:3.12(注意:3.14 太新,ONNX Runtime 暂不支持,别踩坑)
- 环境管理:强烈建议用 Conda 隔离依赖
- 硬件:任意能跑 Python 的机器;想快就上 GPU(可选)
- 联网:首次运行会自动从 HuggingFace 下载模型权重(国内可用 ModelScope 镜像加速)
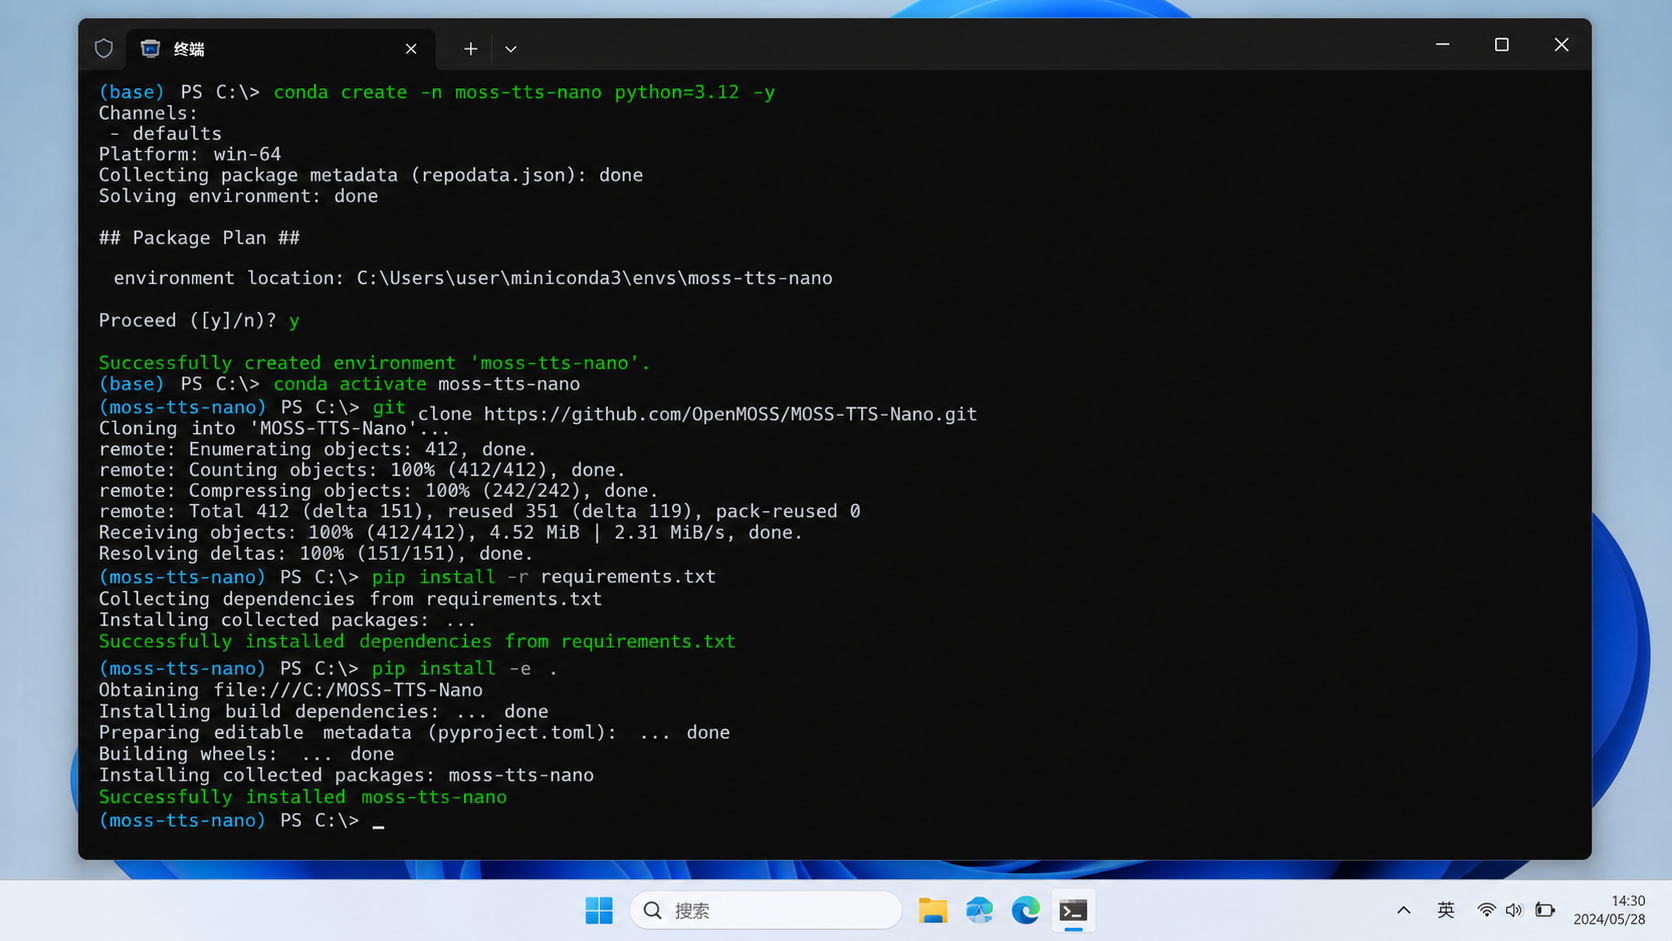
四、安装(Conda 推荐方式)
4.1 创建并激活环境
<code class="language-bash">conda create -n moss-tts-nano python=3.12 -y
conda activate moss-tts-nano
</code>
4.2 克隆仓库并安装
<code class="language-bash">git clone https://github.com/OpenMOSS/MOSS-TTS-Nano.git
cd MOSS-TTS-Nano

pip install -r requirements.txt
pip install -e .
</code>
装完后,本地就能直接用 moss-tts-nano 命令;代码默认加载 OpenMOSS-Team/MOSS-TTS-Nano 与 OpenMOSS-Team/MOSS-Audio-Tokenizer-Nano。
4.3 依赖坑:WeTextProcessing / pynini 装不上怎么办
不少人在这一步翻车。官方给的稳妥解法是先装 pynini,再装 WeTextProcessing:
<code class="language-bash">conda install -c conda-forge pynini=2.1.6.post1 -y
pip install git+https://github.com/WhizZest/WeTextProcessing.git
pip install -r requirements.txt
</code>
非 Conda 用户:先去找对应 Python 版本 / 平台的 pynini wheel 装上,再装 WeTextProcessing(详见仓库 Issue #6)。
五、第一次跑通:语音克隆推理
仓库自带示例参考音频。用 infer.py 做语音克隆(这是官方主推工作流):
<code class="language-bash">python infer.py
  --prompt-audio-path assets/audio/zh_1.wav
  --text "欢迎关注模思智能、上海创智学院与复旦大学自然语言处理实验室。"
</code>
--prompt-audio-path:你的参考音频(3–5 秒即可,越干净越好)--text:要合成的文字- 默认输出:
generated_audio/infer_output.wav
把 zh_1.wav 换成你自己的录音,就能"用自己的声音读任何话"。
六、本地 Web Demo(浏览器里点着玩)
<code class="language-bash">python app.py
</code>
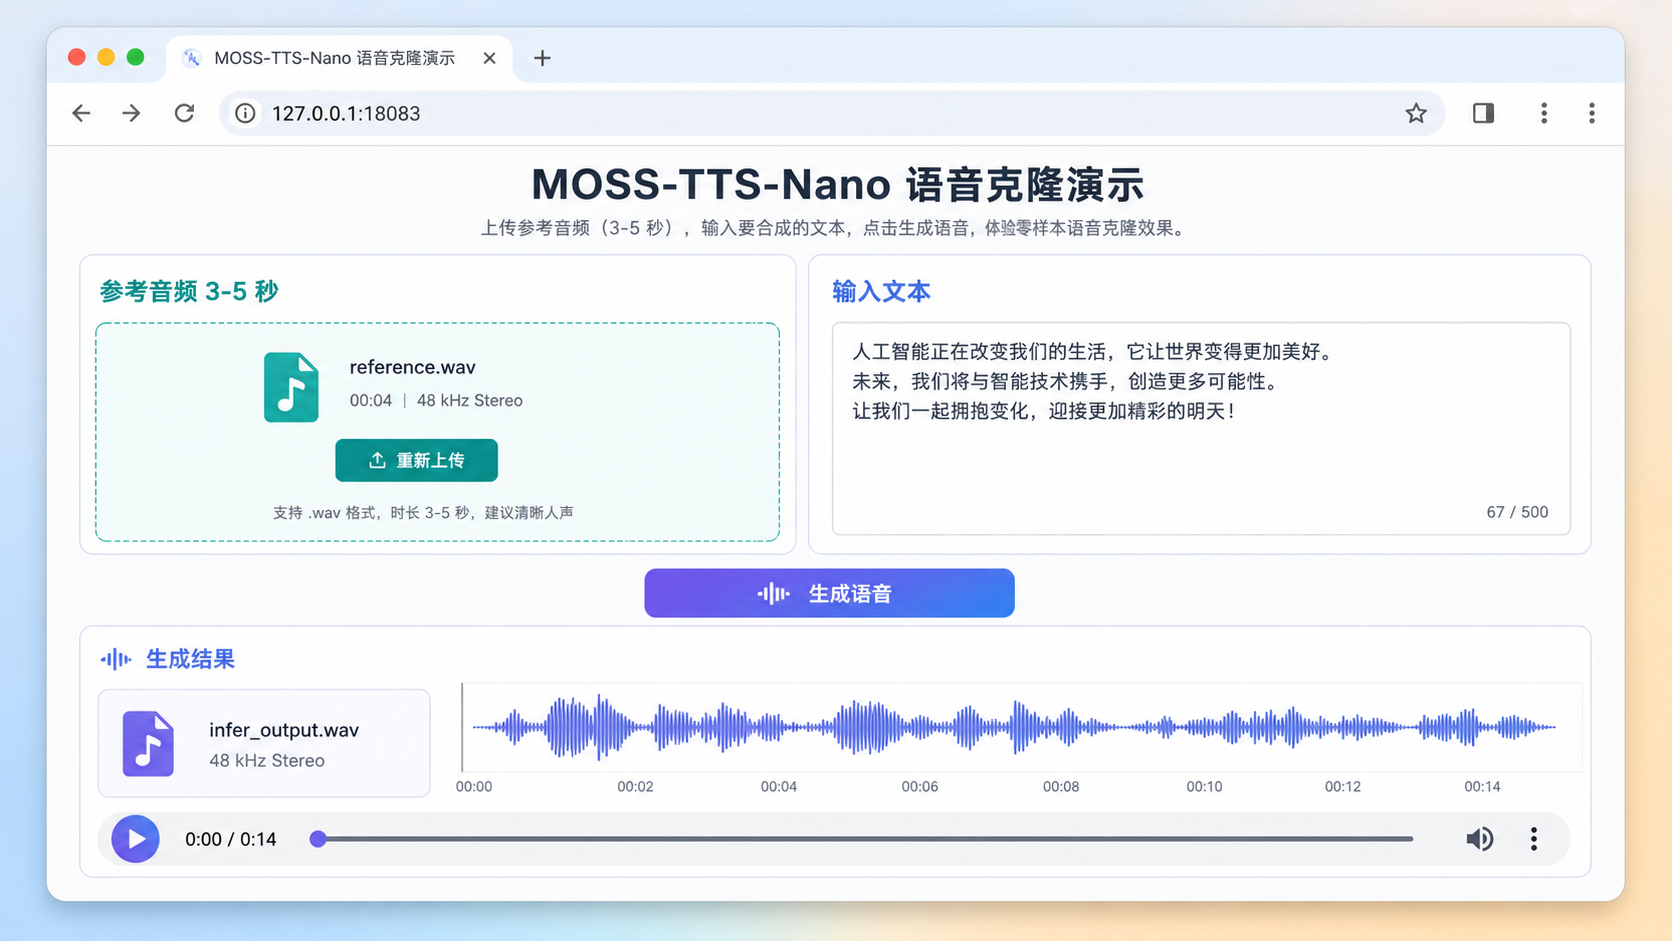
然后浏览器打开 **http://127.0.0.1:18083**,可视化上传参考音频、输入文本、试听下载,适合先体验再集成。
七、ONNX CPU 版(重点推荐,更轻更快)
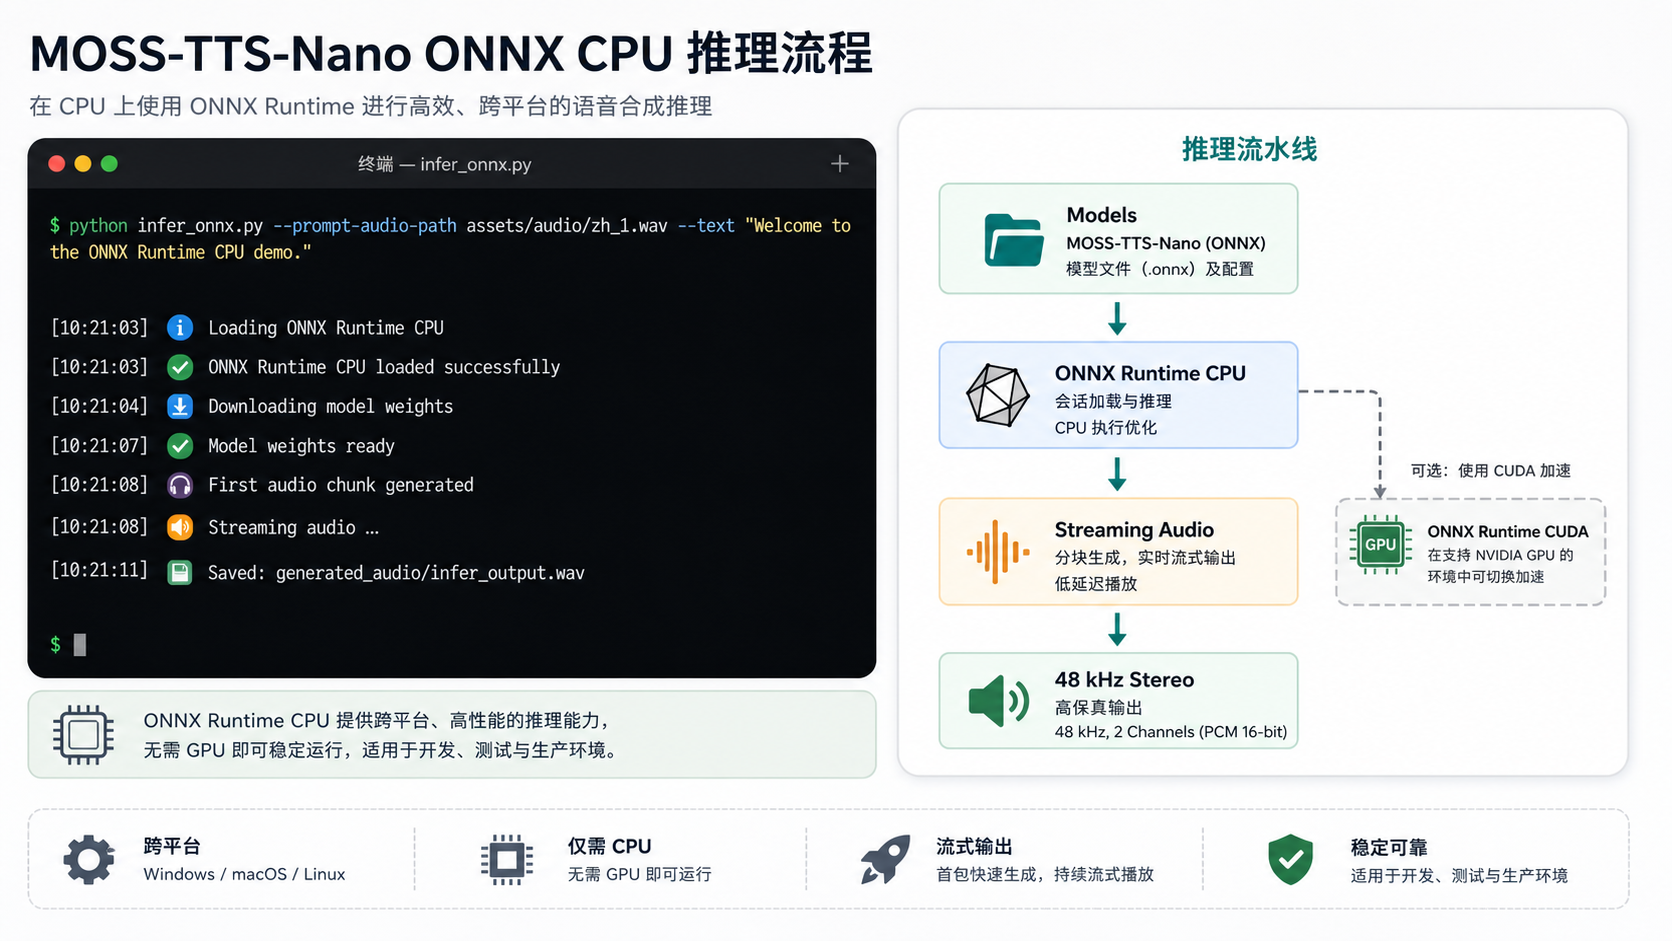
官方现在首推 ONNX CPU 版,尤其适合纯 CPU / 轻量部署:
- 推理期不依赖 PyTorch,只跑 ONNX Runtime CPU;
- 效率较原版接近翻倍;
- 完整保留音色克隆工作流。
<code class="language-bash">python infer_onnx.py
  --prompt-audio-path assets/audio/zh_1.wav
  --text "Welcome to the ONNX Runtime CPU demo."
</code>
想走 GPU(需先装 GPU 版 ONNX Runtime):
<code class="language-bash">pip uninstall -y onnxruntime
pip install "onnxruntime-gpu>=1.20.0"

python infer_onnx.py
  --execution-provider cuda
  --prompt-audio-path assets/audio/zh_1.wav
  --text "Welcome to the ONNX Runtime CUDA demo."
</code>
模型自动下载:首次运行若本地 ./models 没有权重,会自动从以下 HuggingFace 仓库拉取(国内慢可用 ModelScope 镜像):
OpenMOSS-Team/MOSS-TTS-Nano-100M-ONNXOpenMOSS-Team/MOSS-Audio-Tokenizer-Nano-ONNX
ONNX 版也有 Web Demo:python app_onnx.py(CUDA 加 --execution-provider cuda),同样开 **http://127.0.0.1:18083**。
八、CLI 命令(集成到脚本最方便)
装了 pip install -e . 后,直接用打包命令:
<code class="language-bash"># 生成(默认 PyTorch 后端)
moss-tts-nano generate
  --prompt-speech assets/audio/zh_1.wav
  --text "欢迎关注模思智能、上海创智学院与复旦大学自然语言处理实验室。"

# 切 ONNX CPU 后端
moss-tts-nano generate --backend onnx
  --prompt-speech assets/audio/zh_1.wav --text "..."

# ONNX + CUDA
moss-tts-nano generate --backend onnx --execution-provider cuda
  --prompt-speech assets/audio/zh_1.wav --text "..."

# 起本地服务(浏览器 Demo + HTTP 端点,便于服务化)
moss-tts-nano serve
moss-tts-nano serve --backend onnx
</code>
- 默认输出:
generated_audio/moss_tts_nano_output.wav - 长文本可用
--text-file传入,内置自动分块策略,长篇也能稳定流式输出
九、进阶玩法
- 浏览器插件 MOSS-TTS-Nano-Reader:基于 ONNX 版,直接在浏览器内本地朗读网页,不用单独部署推理服务(https://github.com/OpenMOSS/MOSS-TTS-Nano-Reader)
- Android 示例:
examples/android_onnx_runtime,设备端合成短音频写 WAV - 微调:
./finetuning/README.md提供了微调代码,想定制专属音色可深入 - 导出 TTS-only ONNX:
python onnx/export_hf_to_tts_onnx.py --checkpoint-path ... --output-dir ...,便于重训后重新部署
十、常见问题与坑
| 问题 | 解法 |
|---|---|
pynini / WeTextProcessing 装不上 |
先用 Conda 装 pynini,再装 WeTextProcessing(见 4.3) |
| Python 版本报错 | 锁定 3.12,别用 3.14(ONNX Runtime 不支持) |
| 模型下载慢 / 失败 | 国内改用 ModelScope 镜像,或手动下载权重放 ./models |
| 中文路径 / 文件名报错 | 参考音频和文本路径尽量用英文,避免空格和中文 |
| 想要 GPU 加速 | ONNX 版装 onnxruntime-gpu>=1.20.0,推理加 --execution-provider cuda |
| 音质"不够惊艳" | Nano 定位是"够用的实时音质",要极致听感可看同家族 8B 的 MOSS-TTS |
十一、一句话结论
如果你想要一个"不要显卡、CPU 就能实时跑、音质还是 48kHz 立体声、还能 3 秒克隆你声音、支持 20 种语言"的开源 TTS,MOSS-TTS-Nano 目前几乎是本地部署门槛最低的那个答案。
把它接进你的视频工作流、数字人或出海应用,本地一键合成,隐私不出本机——这波"减负革命",值得上车。
💬 互动时间
你平时用哪个 TTS?是被显卡劝退过,还是被"电话音"劝退过?评论区聊聊,或者说说你最想拿它做什么,我下篇可以专门讲讲"用 MOSS-TTS-Nano 给视频批量配音"的实战。
📌 资料来源
- GitHub 仓库:https://github.com/OpenMOSS/MOSS-TTS-Nano
- 在线 Demo:https://openmoss.github.io/MOSS-TTS-Nano-Demo/
- HuggingFace:https://huggingface.co/OpenMOSS-Team/MOSS-TTS-Nano (ModelScope 镜像:https://modelscope.cn/models/openmoss/MOSS-TTS-Nano)
- 论文:https://arxiv.org/abs/2603.18090
- 浏览器插件:https://github.com/OpenMOSS/MOSS-TTS-Nano-Reader
- 部分特性描述参考官方 README 与社区评测(以官方最新版为准)


